lynx cwac-2026/talk.html
智能体时代,复杂业务为什么需要本体
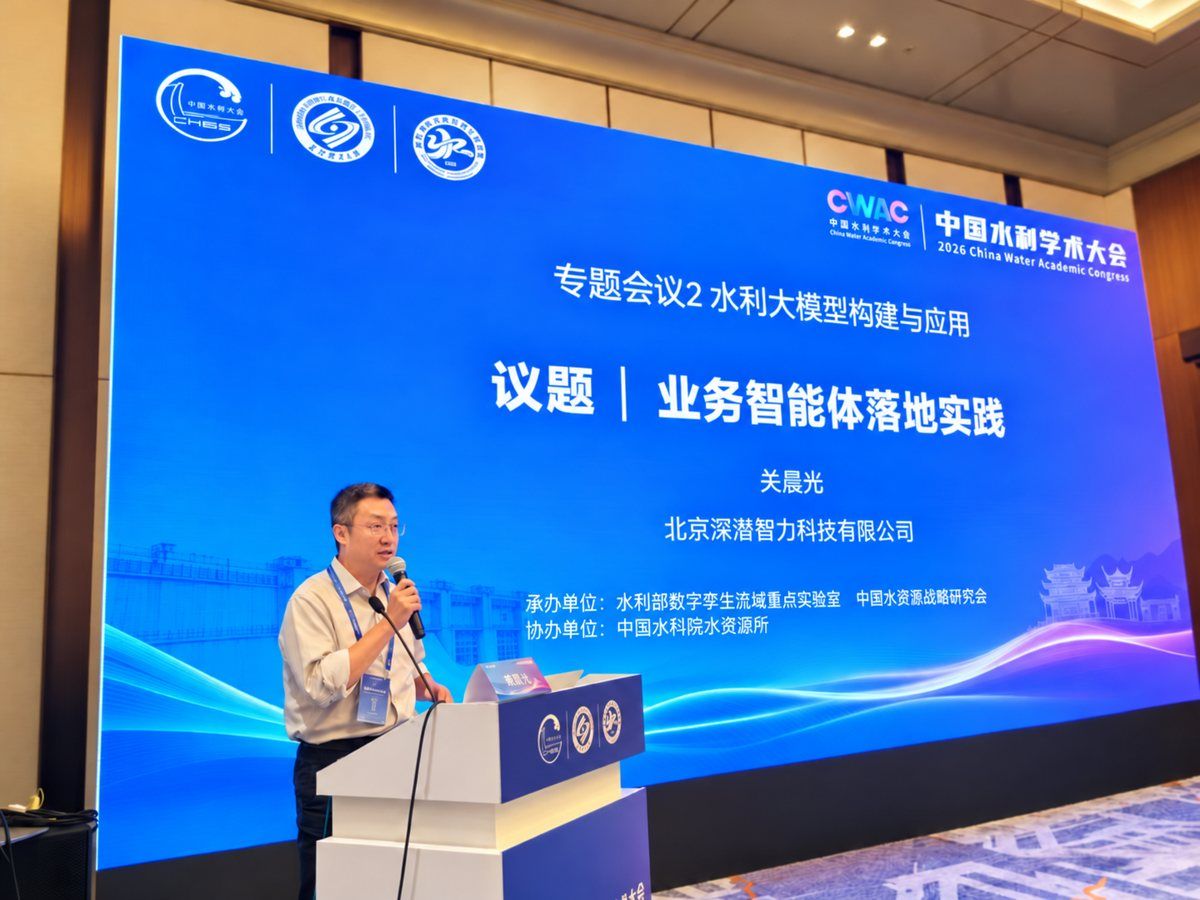
《业务智能体落地实践》报告回顾
我们凭什么相信它的业务判断
当大模型从“回答问题”走向“替人办事”,这是一个越来越现实的问题
2026 年 10 月 15 日至 16 日,2026 中国水利学术大会在湖南长沙举行,大会以“数智赋能,助力水利高质量发展”为主题,由中国水利学会、长沙理工大学、湖南省水利水电科学研究院共同主办,设 19 场专题会议、277 个学术报告,千余位代表参会
专题会议2由水利部数字孪生流域重点实验室、中国水资源战略研究会承办,中国水科院水资源所协办
- 业务建模正在从隐式走向显式:过去,业务模型藏在代码里,后来藏在模型参数里,大模型的语义理解能力,第一次让业务人员可以用自然语言直接描述、查看和修改业务模型
- 复杂业务的确定性,不能只向大模型索取:本体把业务对象、关系、规则和状态显式表达出来,成为人和智能体共同理解的“业务世界”
- 落地是效果、效率、成本的权衡:不是一个最强的模型包办一切,而是代码、判断模型、专家模型和大模型各做擅长的事,由本体串联在一起
- 有了本体,业务结论可推理、可溯源、可审计
业务建模四十年:从“藏在代码里”到“藏在模型里”
每一代企业软件做的都是同一件事:把业务搬进系统,区别只在于业务模型放在哪里、谁来建、用户看不看得见
- 信息化:业务模型在实现层,散落在类、表和映射配置里,只有开发人员看得懂,换一套系统就要重建一遍
- 数字化:主数据、指标体系和知识图谱让业务语义开始跨系统共享,用户能看指标,但难改逻辑
- 机器学习与深度学习:业务知识先是一半在特征里、一半在参数里,后来连特征都交给机器自己学,建模整体进入黑盒
- 大模型:业务知识被压缩进海量参数,RAG 让回答附上出处,是一次重要的缓解,但它追溯的是“信息从哪来”,而不是“结论是怎么推出来的”
+--------------+--------------------+--------------+
| 阶段         | 建模在哪           | 用户可见     |
+--------------+--------------------+--------------+
| 信息化 1980~ | 数据库表、表单、类 | 看不见       |
+--------------+--------------------+--------------+
| 数字化 2010~ | 主数据、指标、图谱 | 部分可见     |
+--------------+--------------------+--------------+
| AI 2015~     | 特征与模型参数     | 越来越看不见 |
+--------------+--------------------+--------------+
| 大模型 2023~ | 千亿级模型参数     | 答案可见     |
+--------------+--------------------+--------------+
| 智能体 2025~ | 业务本体           | 显式、可交互 |
+--------------+--------------------+--------------+
到了智能体阶段,系统要发起催办、变更交期、给出评分、触发预警,答错一个问题,人还可以不采纳,做错一件事,后果是实打实的,确定性、可解释性和可控性从加分项变成了门槛
这时两股力量同时出现:一边是模型越大越难解释,另一边是大模型的语义理解能力,让业务对象、关系和规则可以用业务人员熟悉的语言描述,再由模型协助抽取、校验和维护
业务建模从隐式变为显式
从开发人员的专属能力,变成用户可视、可理解、可交互的共同语言
这种显式的业务模型,就是本体
大模型应用:几年里把企业软件几十年的路又走了一遍
企业应用用了几十年,从围绕流程走到围绕数据,再到围绕智能,最后走到围绕业务对象;大模型应用只用了短短几年,从围绕知识到围绕流程,再到围绕智能,如今同样走到了围绕业务对象
工作流的优势是稳定,Agent Loop 的优势是灵活,对象驱动的业务智能体把两者合起来:程序守住任务、权限、资源和监控的边界,大模型在边界内规划路径,执行结果写回并更新业务对象
业务本体:可推理、可溯源、可审计
对业务对象、属性、关系、状态、约束、权限和可执行动作的显式建模
这里说的本体,不是把文档画成一张关系图,也不是堆砌“实体—关系—实体”三元组,它是人和智能体共同理解的业务世界
本体也不必一开始就上重型系统,可以承载在数据表、JSON/YAML、图数据库或知识图谱里,关键是把业务对象、关系、规则和口径先梳理清楚
- 可推理
- 沿着业务关系一步步推导,结论由事实和规则推出,而不是由模型“猜”出来
- 可溯源
- 每个事实都能回到来源:哪份文件、第几页、哪个系统、哪个版本,保留的是证据与对象、规则、结论之间的对应关系
- 可审计
- 什么时间、用了哪个工具和哪个版本的规则、输入输出是什么、谁做了人工确认,全部留痕,规则后来变了,也能还原“当时为什么这样判”
落到系统里,就是首页所说的证据链、判断链和动作链
[NOTE]本体本身不会自动保证事实正确,只有与取证、校验、规则治理和审计机制配套,这三种能力才能真正落地
务实的架构:效果、效率、成本三角权衡
很多团队落地智能体的第一反应是用最强的模型、给最长的上下文,但在真实业务里,三者很难同时做到最好
cat tradeoff.md
                +--------+
                |  效果  |
                +--------+
                    /\
                   /  \
          更强    /    \    更强
          更贵   /      \   更慢
                / 务实解 \
               /          \
              / 代码+规则  \
             /   判断模型   \
            /    专家模型    \
           /      + LLM       \
  +--------+                  +--------+
  |  效率  |------------------|  成本  |
  +--------+    更快  更弱    +--------+
- 效果
- 模型能力越强、上下文越长、外部知识越充分,效果通常越好,但单纯追求效果,往往更慢、更贵
- 效率
- 小模型和流程模型通常更快,代码几乎没有延时,合理的缓存与检索能提速
- 成本
- 参数越大、上下文越长,调用越贵,用工程手段和判断模型替代一部分大模型调用,可以显著降低成本
三角的中间是务实解:代码、规则、判断模型、专家模型和大模型,各自承担最擅长的部分
cat architecture.md
+--------------------------------------------+    +------------+
| 用户请求 / 业务事件 / 外部触发             |    | 横贯各层   |
+--------------------------------------------+    |            |
                      |                           |            |
                      v                           |            |
+-- 编排层 Agent Loop -----------------------+    |            |
| 任务拆解、工具循环                         |    |            |
| 状态、权限、监控回溯                       |    | - 权限     |
+--------------------------------------------+    |            |
                      ^                           |            |
                      v                           |            |
+-- RAG -------------+  +-- 智能问数 --------+    |            |
| 非结构化检索       |  | 结构化检索         |    |            |
| 文档、制度、FAQ    |  | 数据表、指标库     |    | - 证据     |
+--------------------+  +--------------------+    |            |
                      ^                           |            |
                      v                           |            |
+== 本体 / 业务对象模型层 ===================+    |            |
| 业务对象、关系、语义口径                   |    |            |
| 约束、权限、状态与逻辑                     |    | - 版本     |
| 三大基础能力围绕同一套对象工作             |    |            |
+============================================+    |            |
           按需调度 v   ^ 结果写回                |            |
+-- 能力层:按需调用 ------------------------+    |            |
| +-- 代码 / 规则 ---+  +-- 判断模型 ------+ |    |            |
| | 业务逻辑校验     |  | 分类排序判断     | |    | - 质量评测 |
| +------------------+  +------------------+ |    |            |
| +-- 大模型 LLM ----+  +-- OCR / VLM -----+ |    |            |
| | 语义理解与推理   |  | 文档图像解析     | |    |            |
| +------------------+  +------------------+ |    |            |
| +-- Embedding -----+  +-- Reranker ------+ |    |            |
| | 向量检索         |  | 检索结果重排     | |    | - 审计     |
| +------------------+  +------------------+ |    |            |
| +-- 专家模型 ----------------------------+ |    |            |
| | 行业模型、机理模型、时序预测           | |    |            |
| +----------------------------------------+ |    |            |
+--------------------------------------------+    |            |
                      ^                           | - 人工确认 |
                      |                           |            |
+-- 数据与系统 ------------------------------+    |            |
| 结构化:数据库、指标库                     |    |            |
| 非结构化:文档、制度、报告                 |    |            |
| 业务系统:ERP、CRM、工单、API              |    |            |
+--------------------------------------------+    +------------+
+--------------------------------------------+
| 用户请求 / 业务事件 / 外部触发             |
+--------------------------------------------+
                      |
                      v
+-- 编排层 Agent Loop -----------------------+
| 任务拆解、工具循环                         |
| 状态、权限、监控回溯                       |
+--------------------------------------------+
                      ^
                      v
+-- RAG -------------+  +-- 智能问数 --------+
| 非结构化检索       |  | 结构化检索         |
| 文档、制度、FAQ    |  | 数据表、指标库     |
+--------------------+  +--------------------+
                      ^
                      v
+== 本体 / 业务对象模型层 ===================+
| 业务对象、关系、语义口径                   |
| 约束、权限、状态与逻辑                     |
| 三大基础能力围绕同一套对象工作             |
+============================================+
           按需调度 v   ^ 结果写回
+-- 能力层:按需调用 ------------------------+
| +-- 代码 / 规则 ---+  +-- 判断模型 ------+ |
| | 业务逻辑校验     |  | 分类排序判断     | |
| +------------------+  +------------------+ |
| +-- 大模型 LLM ----+  +-- OCR / VLM -----+ |
| | 语义理解与推理   |  | 文档图像解析     | |
| +------------------+  +------------------+ |
| +-- Embedding -----+  +-- Reranker ------+ |
| | 向量检索         |  | 检索结果重排     | |
| +------------------+  +------------------+ |
| +-- 专家模型 ----------------------------+ |
| | 行业模型、机理模型、时序预测           | |
| +----------------------------------------+ |
+--------------------------------------------+
                      ^
                      |
+-- 数据与系统 ------------------------------+
| 结构化:数据库、指标库                     |
| 非结构化:文档、制度、报告                 |
| 业务系统:ERP、CRM、工单、API              |
+--------------------------------------------+

+-- 横贯各层 --------------------------------+
| 权限、证据、版本、质量评测、审计、人工确认 |
+--------------------------------------------+
落到系统上的分层架构
- 三大基础能力围绕本体协同:RAG、智能问数和 Agent Loop 不是各自为战,而是围绕同一套业务对象工作
- 能力层按需调用:判断模型用于问题和选项都明确时的局部语义判断,如分类、排序、二元判断,可以替代相当一部分大模型调用;Embedding 负责向量检索,Reranker 负责检索结果重排;专家模型既包括行业模型、时序预测和异常检测,也包括水文水动力等机理模型
- 治理横贯各层:权限、证据、版本、质量评测和审计贯穿从编排到数据的每一层,高风险判断由有权限的人确认或纠正
选型五原则
- 能用代码解决的,不必交给模型
- 能用判断模型解决的,不必交给大模型
- 先用本体把业务对象、关系、规则、口径和证据梳理清楚
- 根据业务场景选择最合适的技术组合
- 让合适的能力做合适的事,才能持续、稳定、规模化落地
业务越复杂,越需要显式的业务模型
并不是每个场景都需要一套完整的本体,四个场景按业务复杂度递进,所需的建模深度也逐级加深
对水利行业的启发
把台风理赔场景里的对象和规则替换一下,就是同一套思路
水利行业已经积累了大量监测数据、GIS 空间能力,以及洪水演进、水库调度等专业机理模型,数字孪生流域建设也在持续推进
专业模型负责可信计算,本体负责连接工程对象与业务含义,规则负责约束决策,智能体负责调度工具和解释过程,关键环节由人把关
[INFO]本体不替代水文水动力等机理模型,大模型也不应凭空计算洪水过程,本体要做的,是让专业模型的结果进入业务决策:从“能预测”走向“能解释、能协同、能执行、可审计”
diff -y typhoon-claim.md flood-control.md
+------------------+------------------+
| 台风理赔(演示) | 水利场景         |
+------------------+------------------+
| 台风影响边界     | 洪水演进结果     |
+------------------+------------------+
| 仓库、保险标的   | 河段、堤防、水库 |
+------------------+------------------+
| 保单、客户       | 责任单位、预案   |
+------------------+------------------+
| 理赔优先级规则   | 预警与调度规则   |
+------------------+------------------+
| 查勘任务         | 处置任务         |
+------------------+------------------+
做事的步骤可以交给模型临场规划,但只有业务对象清晰、稳定,这种临场规划才靠得住
让智能体真正走进关键业务,靠的不是一个更大的模型,而是一个看得见、讲得清、查得到的业务世界